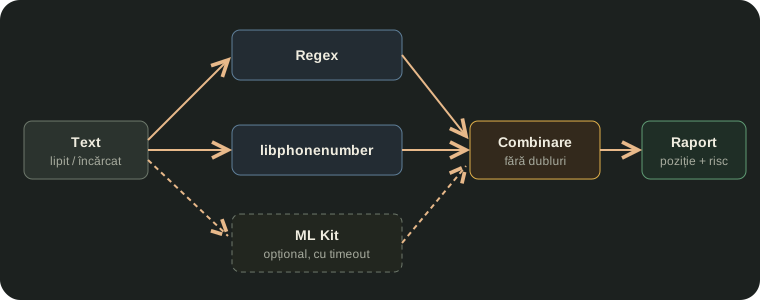
Un fragment de log, un fișier .env sau un email copiat pot conține un CNP, o parolă sau adresa unui server intern. Security Sentinel verifică textul cu trei instrumente diferite, combină rezultatele fără dubluri și apoi înlocuiește sau șterge exact porțiunile pe care le alegi tu.
Articolul explică cum funcționează fiecare detector, cum se combină rezultatele lor și ce nu poate detecta aplicația. Security Sentinel e disponibilă pe Google Play.
Textul nu are metadate, deci problema e conținutul
Un PDF sau o fotografie ascund informații în jurul conținutului. Un text simplu nu are unde să ascundă ceva: tot ce contează e chiar în text. Scanarea caută deci tipare în text și reține pentru fiecare potrivire poziția exactă, de la caracterul X la caracterul Y. Poziția e necesară din două motive: raportul poate evidenția exact acea porțiune, iar redactarea o poate înlocui fără să afecteze restul textului.
Textul poate fi scris de mână, lipit din clipboard sau încărcat dintr-un fișier .txt sau .json. Scanarea rulează local, pe telefon.
Trei instrumente, fiecare cu punctul lui forte
| Instrument | Ce găsește bine | Unde e slab | Disponibil |
|---|---|---|---|
| Expresii regulate (regex) | Email, IP, UUID, căi de fișiere, CNP, chei API, tokenuri | Nu recunoaște nimic fără un format fix (adrese, nume) | Mereu |
| libphonenumber (Google) | Numere de telefon, validate după regulile reale ale fiecărei țări | Un număr local fără + e presupus românesc | Mereu |
| ML Kit Entity Extraction | Adrese poștale scrise liber, IBAN, card, email, telefon | Are nevoie de Google Play Services și de internet la prima descărcare a modelului | Uneori |
Primele două rulează întotdeauna, inclusiv în modul avion. Al treilea funcționează „cât se poate”: are 5 secunde pentru descărcarea modelului și 5 secunde pentru analiză. Dacă nu reușește, întoarce null, nu o listă goală, iar diferența contează. null înseamnă „instrument indisponibil”, iar o listă goală înseamnă „n-am găsit nimic”. Raportul afișează explicit că ML Kit n-a rulat, ca să nu dea impresia că textul e curat.
Regex: tipare fixe, alese ca să evite alarmele false
Regex-ul e rapid și dă mereu același rezultat pentru același text, dar recunoaște orice șir care are forma căutată, chiar dacă nu are sensul căutat. De aceea majoritatea tiparelor au o verificare suplimentară.
CNP: forma și cifra de control
Orice șir de 13 cifre poate arăta ca un CNP. Aplicația verifică în plus prima cifră (1–8) și cifra de control, calculată cu ponderile oficiale:
val ponderi = intArrayOf(2, 7, 9, 1, 4, 6, 3, 5, 8, 2, 7, 9)
val rest = (suma(cifra[i] * ponderi[i]) pentru primele 12) % 11
val control = if (rest == 10) 1 else rest
// CNP valid doar dacă a 13-a cifră == control
Adrese IP: interne față de publice
O adresă din rețeaua locală (10.x, 172.16–31.x, 192.168.x, 127.x) e utilă doar din interiorul aceleiași rețele și primește risc mediu. O adresă publică identifică un server accesibil din internet și primește risc ridicat.
Servere interne
Aplicația nu marchează orice „cuvânt.cuvânt” ca nume de server. Recunoaște doar două forme sigure: un host:port explicit (db.firma.ro:5432) sau un domeniu care nu poate exista public (.local, .internal, .corp, .lan, .intranet). Un domeniu obișnuit, cum ar fi example.com, apărut într-o propoziție nu e marcat.
Căi de fișiere
O cale ca D:\proiecte\raport arată doar structura folderelor (risc redus). O cale care conține un nume de utilizator (C:\Users\ana\…, /home/ana/…) identifică un cont real (risc ridicat).
Chei și parole
Orice secret găsit primește risc ridicat. Tiparele se bazează pe dovezi concrete, nu pe presupuneri statistice:
AKIA...                            // prefix real de cheie AWS
ghp_... / xoxb-... / sk_live_...   // GitHub, Slack, chei de plată
eyJ....eyJ....semnătură            // JWT: trei segmente separate prin punct
postgres://user:parola@db.host     // parolă inclusă în connection string
AWS_SECRET_ACCESS_KEY=...          // linie .env cu un nume de variabilă „secret”
api_key: a8f3k29dk20x...           // valoare lungă cu litere + cifre
La ultima formă, valoarea trebuie să aibă minimum 12 caractere și să conțină atât litere cât și cifre. Astfel, password: secret dintr-o propoziție nu e marcat.
Telefoane: validare, nu doar cifre
Un regex pentru telefon fie prinde orice șir de 10 cifre, fie funcționează pentru o singură țară. libphonenumber analizează fiecare număr posibil și verifică lungimea și prefixele după regulile țării respective. Numerele scrise cu +cod_țară sunt recunoscute pentru orice țară. Cele fără prefix sunt interpretate ca numere românești (regiunea implicită RO).
Combinarea: o singură constatare, confirmată de mai multe surse
Același număr de telefon poate fi găsit atât de libphonenumber, cât și de ML Kit. Aplicația nu îl afișează de două ori. Când două rezultate se suprapun în text, ele devin o singură constatare care păstrează ambele surse („confirmat de 2 instrumente”). Eticheta constatării unite vine de la sursa cea mai sigură:
libphonenumber (validare reală) > regex (exact, fără context) > ML Kit (statistic)Nivelul de risc se stabilește după o regulă observată pe date reale. ML Kit a identificat uneori o adresă IP ca număr de telefon. Dacă s-ar fi luat pur și simplu riscul maxim, riscul ridicat al interpretării greșite („Telefon”) ar fi înlocuit riscul mediu al etichetei corecte („Adresă IPv4”). Regula folosită e:
- Dacă sursele au aceeași categorie, se confirmă reciproc și se păstrează riscul cel mai mare.
- Dacă au categorii diferite, sursa care pierde a interpretat greșit, deci contează doar riscul sursei câștigătoare.
Categorie și risc: două axe separate
Fiecare constatare are o categorie (ce tip de dată e) și un nivel de risc (cât de gravă e expunerea). Cele două nu depind una de alta. De exemplu, în categoria Contact un email are risc ridicat, iar o adresă poștală are risc mediu.
| Categorie | Exemple |
|---|---|
| Date personale | CNP, IBAN, card de plată |
| Contact | email, telefon, adresă poștală |
| Identificatori tehnici | IP, UUID, nume de server, căi de fișiere, URL |
| Secrete | chei API, tokenuri, JWT, parole în connection string sau .env |
Redactarea: de la sfârșit spre început
Pe ecranul de redactare alegi constatările și modul de redactare:
Înlocuire cu etichetă:  Sună-mă la 0722 123 456  →  Sună-mă la [TELEFON]
Eliminare completă:     Sună-mă la 0722 123 456  →  Sună-mă la
Pozițiile tuturor constatărilor sunt calculate pe textul original. Dacă aplicația ar înlocui prima constatare, toate cele de după ea s-ar muta, iar pozițiile lor n-ar mai fi corecte. De aceea redactarea pornește de la ultima constatare și merge spre prima, astfel încât o modificare nu afectează constatările rămase:
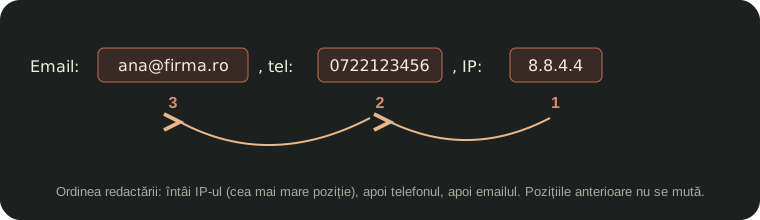
Rezultatul e salvat într-un fișier .txt nou (UTF-8), cu sufixul _clean. Textul original nu e modificat.
Limitări cunoscute
- Numele de persoane nu sunt detectate. Niciunul dintre cele trei instrumente nu recunoaște de încredere un nume într-un text liber.
- ML Kit folosește modelul pentru limba engleză. Adresele scrise în română pot fi recunoscute mai rar.
- Adresele IPv6 sunt recunoscute doar în forma completă (8 grupuri), nu și în forma scurtă cu
::. - Un număr de telefon local străin, scris fără
+cod_țară, poate să nu fie detectat. - Cheile API fără un prefix cunoscut sunt găsite doar când apar după un nume ca
key,token,secretsaupassword.
Toată procesarea rulează local, pe dispozitiv.
Descarcă Security Sentinel de pe Google Play, vezi ce mai verifică aplicația pe pagina produsului sau citește cum curăță metadatele din PDF și DOCX.