Un document pare curat când îl deschizi, dar poate păstra numele autorului, calea de pe disc din care a fost exportat, comentarii uitate sau un script care rulează imediat ce e deschis. Security Sentinel caută aceste urme și scoate doar ce bifezi tu, într-o copie nouă. Textul, imaginile și aranjarea paginilor rămân neschimbate.
Articolul explică cum citește și curăță aplicația fișierele PDF și DOCX și unde sunt limitele ei. Security Sentinel e disponibilă pe Google Play.
De ce nu doar „salvează din nou” sau „tipărește ca PDF”?
Cea mai simplă soluție ar fi ca documentul să fie redesenat de la zero, de exemplu tipărit din nou ca PDF. Metoda asta are trei probleme:
- Conținutul se schimbă. Textul poate deveni imagine, fonturile se pot înlocui, iar linkurile și câmpurile de formular se pierd.
- Nu știi ce s-a scos. Totul dispare deodată, fără o listă a ceea ce a existat.
- Nu poți alege. Uneori vrei să păstrezi data sau titlul și să ștergi doar autorul.
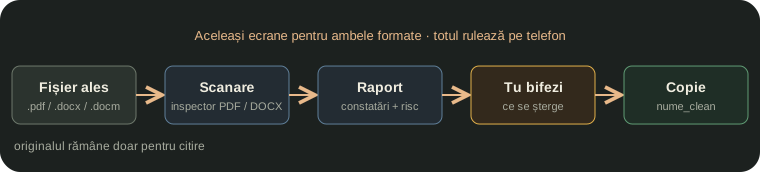
Security Sentinel tratează fișierul ca pe un container. Întâi face un inventar al metadatelor (scanarea). Apoi șterge din container doar elementele pe care le-ai bifat (curățarea). Conținutul paginilor nu e redesenat.
Un singur flux pentru două formate
PDF și DOCX folosesc aceleași ecrane: încărcare, raport, selecție, rezultat. Doar motorul de dedesubt diferă. Formatul e ales după extensia fișierului, deci decizia se ia înainte să se citească vreun octet:
fun documentFormatOf(displayName: String) =
    if (extensie == "docx" || extensie == "docm") DOCX else PDF
Un fișier .doc vechi (format binar, nu arhivă ZIP) trece pe ruta PDF. Acolo nu poate fi citit, iar raportul arată o eroare de citire clară, în loc ca fișierul să dispară fără explicație.
PDF: unde se ascund metadatele
Un PDF poate păstra informații despre autor în două locuri diferite, iar aplicația le citește pe amândouă cu biblioteca PDFBox-Android:
- Document Info Dictionary: lista clasică și scurtă (Author, Creator, Producer, datele de creare și modificare).
- Fluxul XMP: un bloc XML mai nou și mai bogat. Unele aplicații moderne scriu informațiile doar aici, împreună cu câmpuri care lipsesc din lista clasică: istoricul de editare, fișierul din care a fost derivat documentul, drepturile de autor și identificatori unici.
Pe lângă aceste două liste, scanarea verifică și părți ale documentului care nu sunt metadate în sens strict, dar pot divulga informații:
| Ce se verifică | De ce contează | Risc |
|---|---|---|
Autor (Info + XMP dc:creator) | Numele persoanei, direct | ridicat |
| Istoric XMP, „derivat din”, ingrediente | Pot arăta fișierul-sursă și programele folosite anterior | ridicat |
Comentarii (/Text, /FreeText) | Includ numele celui care a comentat | ridicat |
| Semnătură digitală | Numele declarat al semnatarului | ridicat |
| Anexe încorporate | O anexă poate conține mai mult decât documentul însuși | ridicat |
Straturi ascunse (/OCProperties) | Text sau imagini pe care un cititor nu le arată implicit | ridicat |
| ID document și instanță, drepturi, descriere, etichete | Permit urmărirea sau corelarea versiunilor | mediu |
Miniatura paginii (/Thumb) | Poate arăta o versiune mai veche a paginii | mediu |
| Aplicația, generatorul PDF, datele | Urme tehnice despre mediul de lucru | redus |
Când XMP-ul e „stricat”: citire strictă, apoi tolerantă
Parserul XMP standard respinge tot blocul dacă un singur câmp nu are exact formatul așteptat. Cel mai des e vorba de o dată scrisă fără fus orar, lucru foarte frecvent în PDF-urile reale. Fără o soluție de rezervă, ar dispărea din raport și câmpuri corecte, cum ar fi autorul.
Aplicația încearcă întâi citirea strictă. Dacă eșuează, citește direct textul elementelor XML cunoscute, fără să mai verifice tipurile:
val strict = runCatching { DomXmpParser().parse(bytes) }.getOrNull()
val valori = if (strict != null) citesteStrict(strict)
             else citesteTolerant(bytes)   // textul brut din DOM
Curățarea urmează aceeași regulă. Dacă nici citirea tolerantă nu reușește (XML complet deteriorat), aplicația șterge întregul bloc XMP. E mai sigur să șteargă mai mult decât ai cerut decât să lase un câmp pe care l-ai bifat.
Semnale derivate: căi de fișiere și autori care nu se potrivesc
Fiecare valoare găsită, indiferent de câmp, e verificată cu câteva expresii regulate care recunosc o cale de fișier locală sau de rețea:
C:\Users\ana\Documents\oferta.docx     // Windows
\\server-birou\share\contracte\        // rețea (UNC)
/home/ana/...   /Users/ana/...         // Linux / macOS
file:///...                            // URL local
O astfel de cale poate arăta numele de utilizator, numele calculatorului sau structura folderelor, așa că primește o constatare separată, cu risc ridicat. Constatarea inițială rămâne și ea în listă, ca informație simplă.
Dacă autorul din lista clasică diferă de dc:creator din XMP, aplicația raportează discrepanța. Poate însemna că fișierul a fost editat sau convertit de altcineva decât autorul declarat. Aplicația prezintă situația ca fapt, fără să tragă concluzii.
Conținut activ: ce rulează fără click
Un PDF poate declara acțiuni care pornesc singure la deschidere, închidere, salvare, tipărire sau la schimbarea paginii. Aplicația verifică toate locurile unde pot apărea astfel de acțiuni (/OpenAction, /AA pe document și pe pagini, /Names/JavaScript) și le împarte în trei categorii:
| Categorie | Ce poate face | Risc |
|---|---|---|
| JavaScript automat | Execută cod. Poate fi legitim (un formular care își calculează câmpurile) sau nu. | ridicat |
| Lansare program extern | Pornește un fișier sau un program pe calculatorul celui care deschide documentul | ridicat |
| Referință externă automată | Contactează un URL sau un server și poate confirma cine și când a deschis fișierul | mediu |
Raportul afișează și valoarea concretă găsită: scriptul, programul țintă sau URL-ul. Linkurile obișnuite, pe care le apeși tu, sunt ignorate intenționat, pentru că nu reprezintă un risc și ar produce alarme false.
DOCX: de fapt, o arhivă ZIP cu fișiere XML
Un fișier .docx e o arhivă ZIP. Aplicația o deschide cu instrumentele incluse deja în Android (java.util.zip și parserul XML XmlPullParser), fără biblioteci suplimentare. Fiecare fișier din arhivă are un rol:
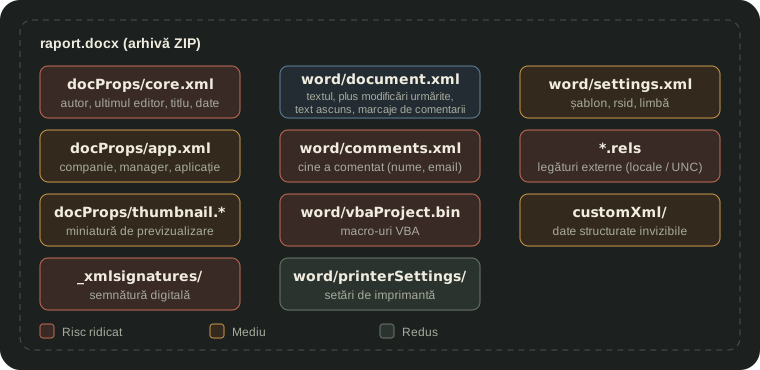
Arhiva e citită integral în memorie ca listă ordonată nume → octeți. Fișierele DOCX reale au de obicei între câțiva KB și câțiva MB, așa că metoda e practică. În plus, curățarea poate modifica doar câteva intrări și copia restul neschimbate.
Curățarea: o copie nouă, cu doar ce ai bifat
Ambele formate respectă aceleași reguli:
- Fișierul original e deschis doar pentru citire. Rezultatul e un fișier nou, cu sufixul
_clean, de exemplucontract_clean.pdf. - Fiecare tip de constatare are o regulă de ștergere corespunzătoare. O constatare derivată șterge câmpul din care provine: „cale de fișier în Autor” șterge Autorul, iar „discrepanță de autor” șterge ambele câmpuri de autor.
Câmpurile clasice se golesc prin PDFBox (info.setAuthor(null)). Din XMP se scot doar proprietățile bifate, apoi blocul e salvat din nou. Miniaturile, comentariile, semnăturile (împreună cu certificatul) și anexele se elimină ca obiecte întregi. Acțiunile automate se șterg doar din categoria bifată: dacă bifezi numai „JavaScript”, o acțiune de lansare a unui program rămâne neatinsă.
DOCX
Fiecare fișier XML e rescris în flux, element cu element, cu două tipuri de filtru:
filterXml(bytes,
    shouldRemove = { /* elimină elementul ȘI tot ce e în el */ },
    shouldUnwrap = { /* elimină doar eticheta, păstrează conținutul */ })
Diferența e importantă la modificările urmărite. Aplicația face practic „Acceptă toate modificările”:
<w:del>text vechi</w:del>                → eliminat (oricum nu se vedea la citire)
<w:ins w:author="Ana">text nou</w:ins>   → text nou (rămâne; dispare doar „Ana”)
Textul ascuns e mai greu de tratat. Când parserul ajunge la începutul unui fragment <w:r>, nu știe încă dacă fragmentul e ascuns. Filtrul păstrează temporar fragmentul întreg și decide abia la final: dacă conține <w:vanish/>, îl elimină, altfel îl scrie neschimbat.
Când se șterge o parte întreagă (semnătura, miniatura, macro-urile), aplicația șterge și referințele către ea din [Content_Types].xml și din fișierele .rels. Altfel Word ar găsi trimiteri către fișiere care nu mai există. Dacă scoți macro-urile dintr-un .docm, copia primește extensia .docx. Dacă le păstrezi, extensia rămâne .docm, ca să nu pară inofensiv un fișier care încă are cod activ.
Principiul de bază: curățarea nu schimbă ce vezi pe pagină. Comentariile, modificările urmărite și textul ascuns sunt tehnic parte din conținut, dar ștergerea lor afectează doar elemente care nu apăreau oricum la o citire normală.
Limitări cunoscute
- Straturile ascunse din PDF sunt doar detectate, nu și șterse. Pentru ștergerea lor ar trebui rescris conținutul paginii instrucțiune cu instrucțiune, cu riscul de a schimba ce se vede.
- Semnăturile digitale sunt raportate după informațiile declarate în ele, fără verificare criptografică.
- În PDF sunt citite doar anexele de pe primul nivel al listei de anexe. E suficient pentru aproape toate documentele reale.
- Acțiunile automate de pe câmpurile individuale ale unui formular PDF nu sunt verificate.
- Textul ascuns din DOCX e detectat doar prin formatarea „Hidden” din Word, nu prin trucuri precum textul alb pe fundal alb.
- Aplicația îți spune că există un macro sau un script și îl arată, dar nu analizează ce face.
- Curățarea nu modifică textul vizibil. Un nume scris în corpul documentului rămâne acolo.
Toată procesarea rulează local, pe dispozitiv.
Descarcă Security Sentinel de pe Google Play, vezi ce mai verifică aplicația pe pagina produsului sau citește cum tratează datele personale dintr-un text simplu.